Amazon Redshift Data API をデータパイプラインの宛先として構成する
データパイプラインの宛先として Amazon Redshift Data API を設定します。このコネクションにより、Workato はソースアプリケーションから Amazon Redshift テーブルにデータをレプリケートし、Redshift Data API を介して Redshift にロードする前に Amazon S3 にデータをステージングできます。
サポートされている機能
Amazon Redshift Data API をパイプラインの宛先として使用する場合、次の機能がサポートされます。
- ソーススキーマに基づく宛先テーブルの自動作成
- 明示的なフィールドマッピングを使用しないフィールドレベルのデータレプリケーション
- Redshift に Redshift Data API を介してロードする前に Amazon S3 にステージングされるデータ
- IAM ロールまたは AWS アクセスキーによる認証
前提条件
Amazon Redshift Data API をデータパイプラインの宛先として接続するには、次が必要です。
- Amazon Redshift クラスターまたはワークグループと、その所在 AWS リージョン
- Redshift にロードする前にデータをステージングするための Amazon S3 バケット
- AWS 認証情報、引き受け対象の IAM ロール ARN、または静的な AWS アクセスキー ID とシークレットアクセスキー
- 接続先となる Redshift データベース名
Amazon Redshift Data API への接続
次の手順を実行して、Amazon Redshift Data API をデータパイプラインの宛先として接続します。このコネクションにより、パイプラインはデータを Amazon Redshift にレプリケートしてロードできます。
Amazon Redshift Data API への接続
作成 > コネクションを選択するか、Cを2回押します。
Amazon Redshift Data APIを検索し、アプリとして選択します。
コネクション名フィールドに名前を入力します。
ロケーションドロップダウンメニューを使用して、コネクションを保存するプロジェクトを選択します。
Authorization type ドロップダウンメニューを使用して AWS 認証情報の指定方法を選択し、その選択内容に応じた手順を実行します。
Redshift クラスターまたはワークグループが配置されている Region を、us-east-1 などの形式で入力します。
Deployment type ドロップダウンメニューを使用して、Redshift のデプロイメントタイプを選択します。
- Redshift Serverless ワークグループには Serverless を選択します。
- プロビジョニング済みの Redshift クラスターには Provisioned を選択します。
選択した Deployment type に応じて、Workgroup name フィールドに Redshift Serverless ワークグループ名、または Cluster identifier フィールドに Redshift クラスターの識別子を入力します。
接続先となる Redshift データベース名を Database フィールドに入力します。
接続をクリックして、コネクションを検証および確立します。
宛先アクションの設定
パイプラインを開始する前に、宛先データベースとスキーマが新規作成済みで空であることを確認します。これにより、初回同期中のエラーを防ぎ、パイプラインが競合なしで送信先テーブルを作成できるようになります。
次の手順を実行して、宛先アクションを構成します。
宛先アプリのターゲットテーブルにデータをロードアクションをクリックします。このアクションでは、パイプラインが宛先でデータをレプリケートする方法を定義します。
利用可能な宛先アプリの一覧から Amazon Redshift Data API を選択します。
このパイプラインで使用する Amazon Redshift Data API コネクションを選択します。または、+ 新規コネクションをクリックして、新しいコネクションを作成します。
Load data to target table in destination app アクションは、ソースから Redshift へのオブジェクトスキーマのレプリケーションを自動的に実行します。明示的なフィールドマッピングは不要です。
S3 staging bucket フィールドを使用して、Workato が Redshift にロードする前にデータをステージングする S3 バケットを選択します。または、バケット名を直接入力します。
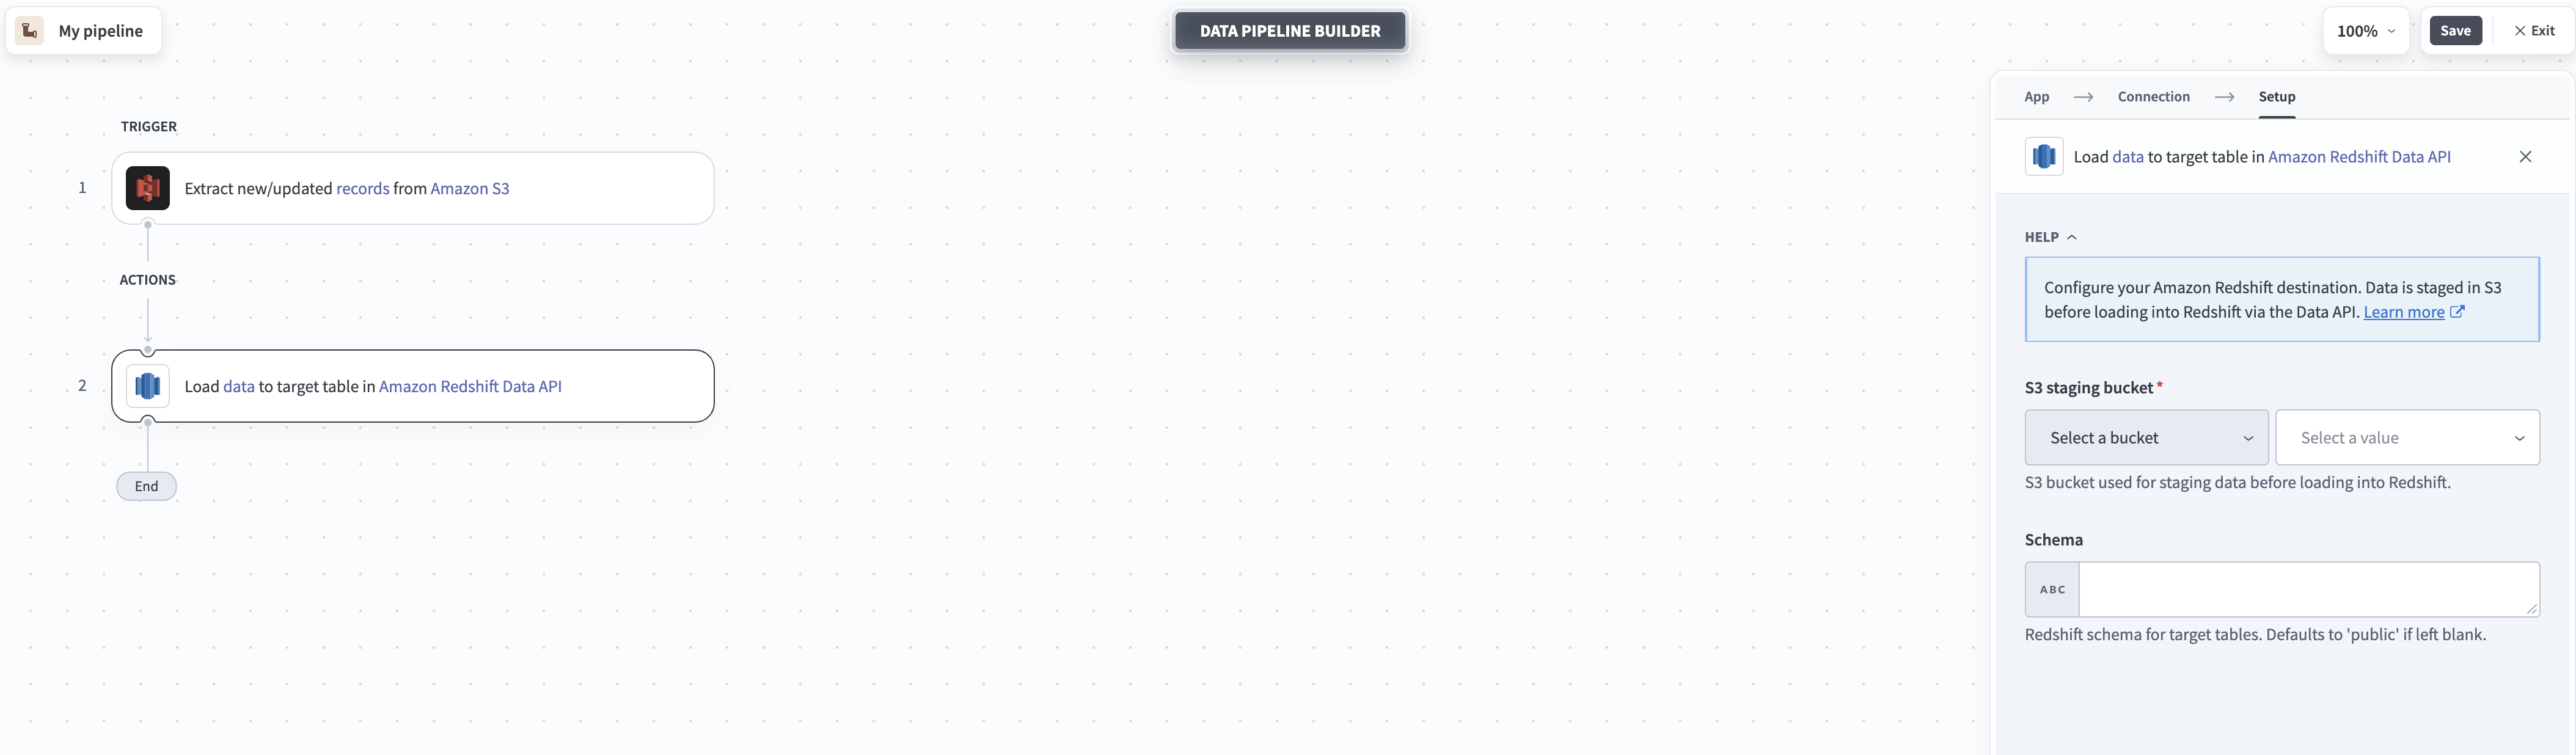 Amazon Redshift Data API 宛先の構成
任意。 Schema フィールドで、ターゲットテーブル用の Redshift スキーマを設定します。このフィールドを空白のままにすると、Workatoはpublicスキーマを使用します。
保存を選択してパイプラインを保存します。
最終更新日: