データパイプライン
データパイプラインは、ソースアプリケーションやファイルからデータウェアハウスへのデータの移動を自動化します。レコードを1件ずつ処理するのではなく、複数のデータオブジェクトを並列で同期できるため、大規模なデータ転送がより高速で信頼性の高いものになり、メンテナンスも容易になります。
データパイプラインを使用する理由
標準レシピでは、オブジェクトごとに個別のワークフローが必要であり、レコードは小さなバッチで処理されます。このアプローチでは、セットアップ時間が増加し、同期時間が長くなり、障害復旧が複雑になります。
データパイプラインは、複数のオブジェクト同期を単一のワークフローに統合することで、レプリケーションを効率化します。パイプラインは完全な履歴同期から開始し、その後Change Data Capture(CDC)を使用した増分同期に切り替わります。これにより、挿入、更新、削除が自動的にキャプチャされます。パイプラインはスキーマの変更も検出し、更新を適用して宛先の整合性を維持します。
主な利点
データパイプラインには、次の機能があります:
- 自動スキーマ管理:スキーマの変更を検出し、宛先に適用します。
- 最適化された変更追跡:CDCを使用して、新規、変更済み、削除済みのレコードをキャプチャします。
- メンテナンス作業の削減:複数のレシピを単一のパイプラインに置き換え、セットアップ、監視、エラー処理を簡素化します。
- 可観測性の向上:Data Orchestrationダッシュボードとパイプライン実行履歴を通じて、スキーマの変更、データ量、エラーを表示します。
データパイプラインの仕組み
データパイプラインは、抽出、複製、ロード、同期のプロセスに従ってデータ移動を自動化します:
- 抽出:トリガーは、Salesforceなどのソースアプリケーションからデータを取得します。
- 複製:パイプラインはスキーマを複製し、宛先との互換性を確保します。
- ロード:ロードアクションは、Snowflakeなどの宛先にレコードを一括転送します。
パイプラインは、スケジュールされた間隔でデータを同期します。選択されたすべてのオブジェクトに対して、抽出、複製、ロードのプロセスを実行します。トリガーはソースからデータを抽出し、ロードアクションはスキーマを複製してレコードを宛先に転送します。
前提条件
データパイプラインを作成する前に、次のものがあることを確認してください。
- Salesforce、NetSuite2、Jira、Coupa、Marketoなど、サポートされているソースアプリケーション
- Snowflake、Databricks、SQL Serverなど、サポートされている宛先データウェアハウス
- 両方のシステムに必要なアクセス権と認証情報
- ソースシステムのスキーマとオブジェクトに関する知識。この情報は通常、各アプリケーションの製品ドキュメントで確認できます。たとえば、Salesforce標準オブジェクトリファレンスを参照してください。
データパイプラインの利用開始
アプリケーション間でデータを同期するデータパイプラインレシピを設定するには、次のガイドを参照してください:
- データパイプラインのソースの設定:サポートされているソースアプリケーションに接続し、認証を行い、オブジェクトを選択して、スキーマを定義します。
- データパイプラインの宛先の設定:サポートされている宛先データウェアハウスに接続し、データのロード方法を設定します。
- パイプラインの監視と管理:同期の進行状況を追跡し、エラーをトラブルシューティングします。
データパイプラインの開始
パイプラインを開始を選択して、データパイプラインを開始します。パイプラインを開始すると、選択したオブジェクトが同期され、履歴データがロードされます。
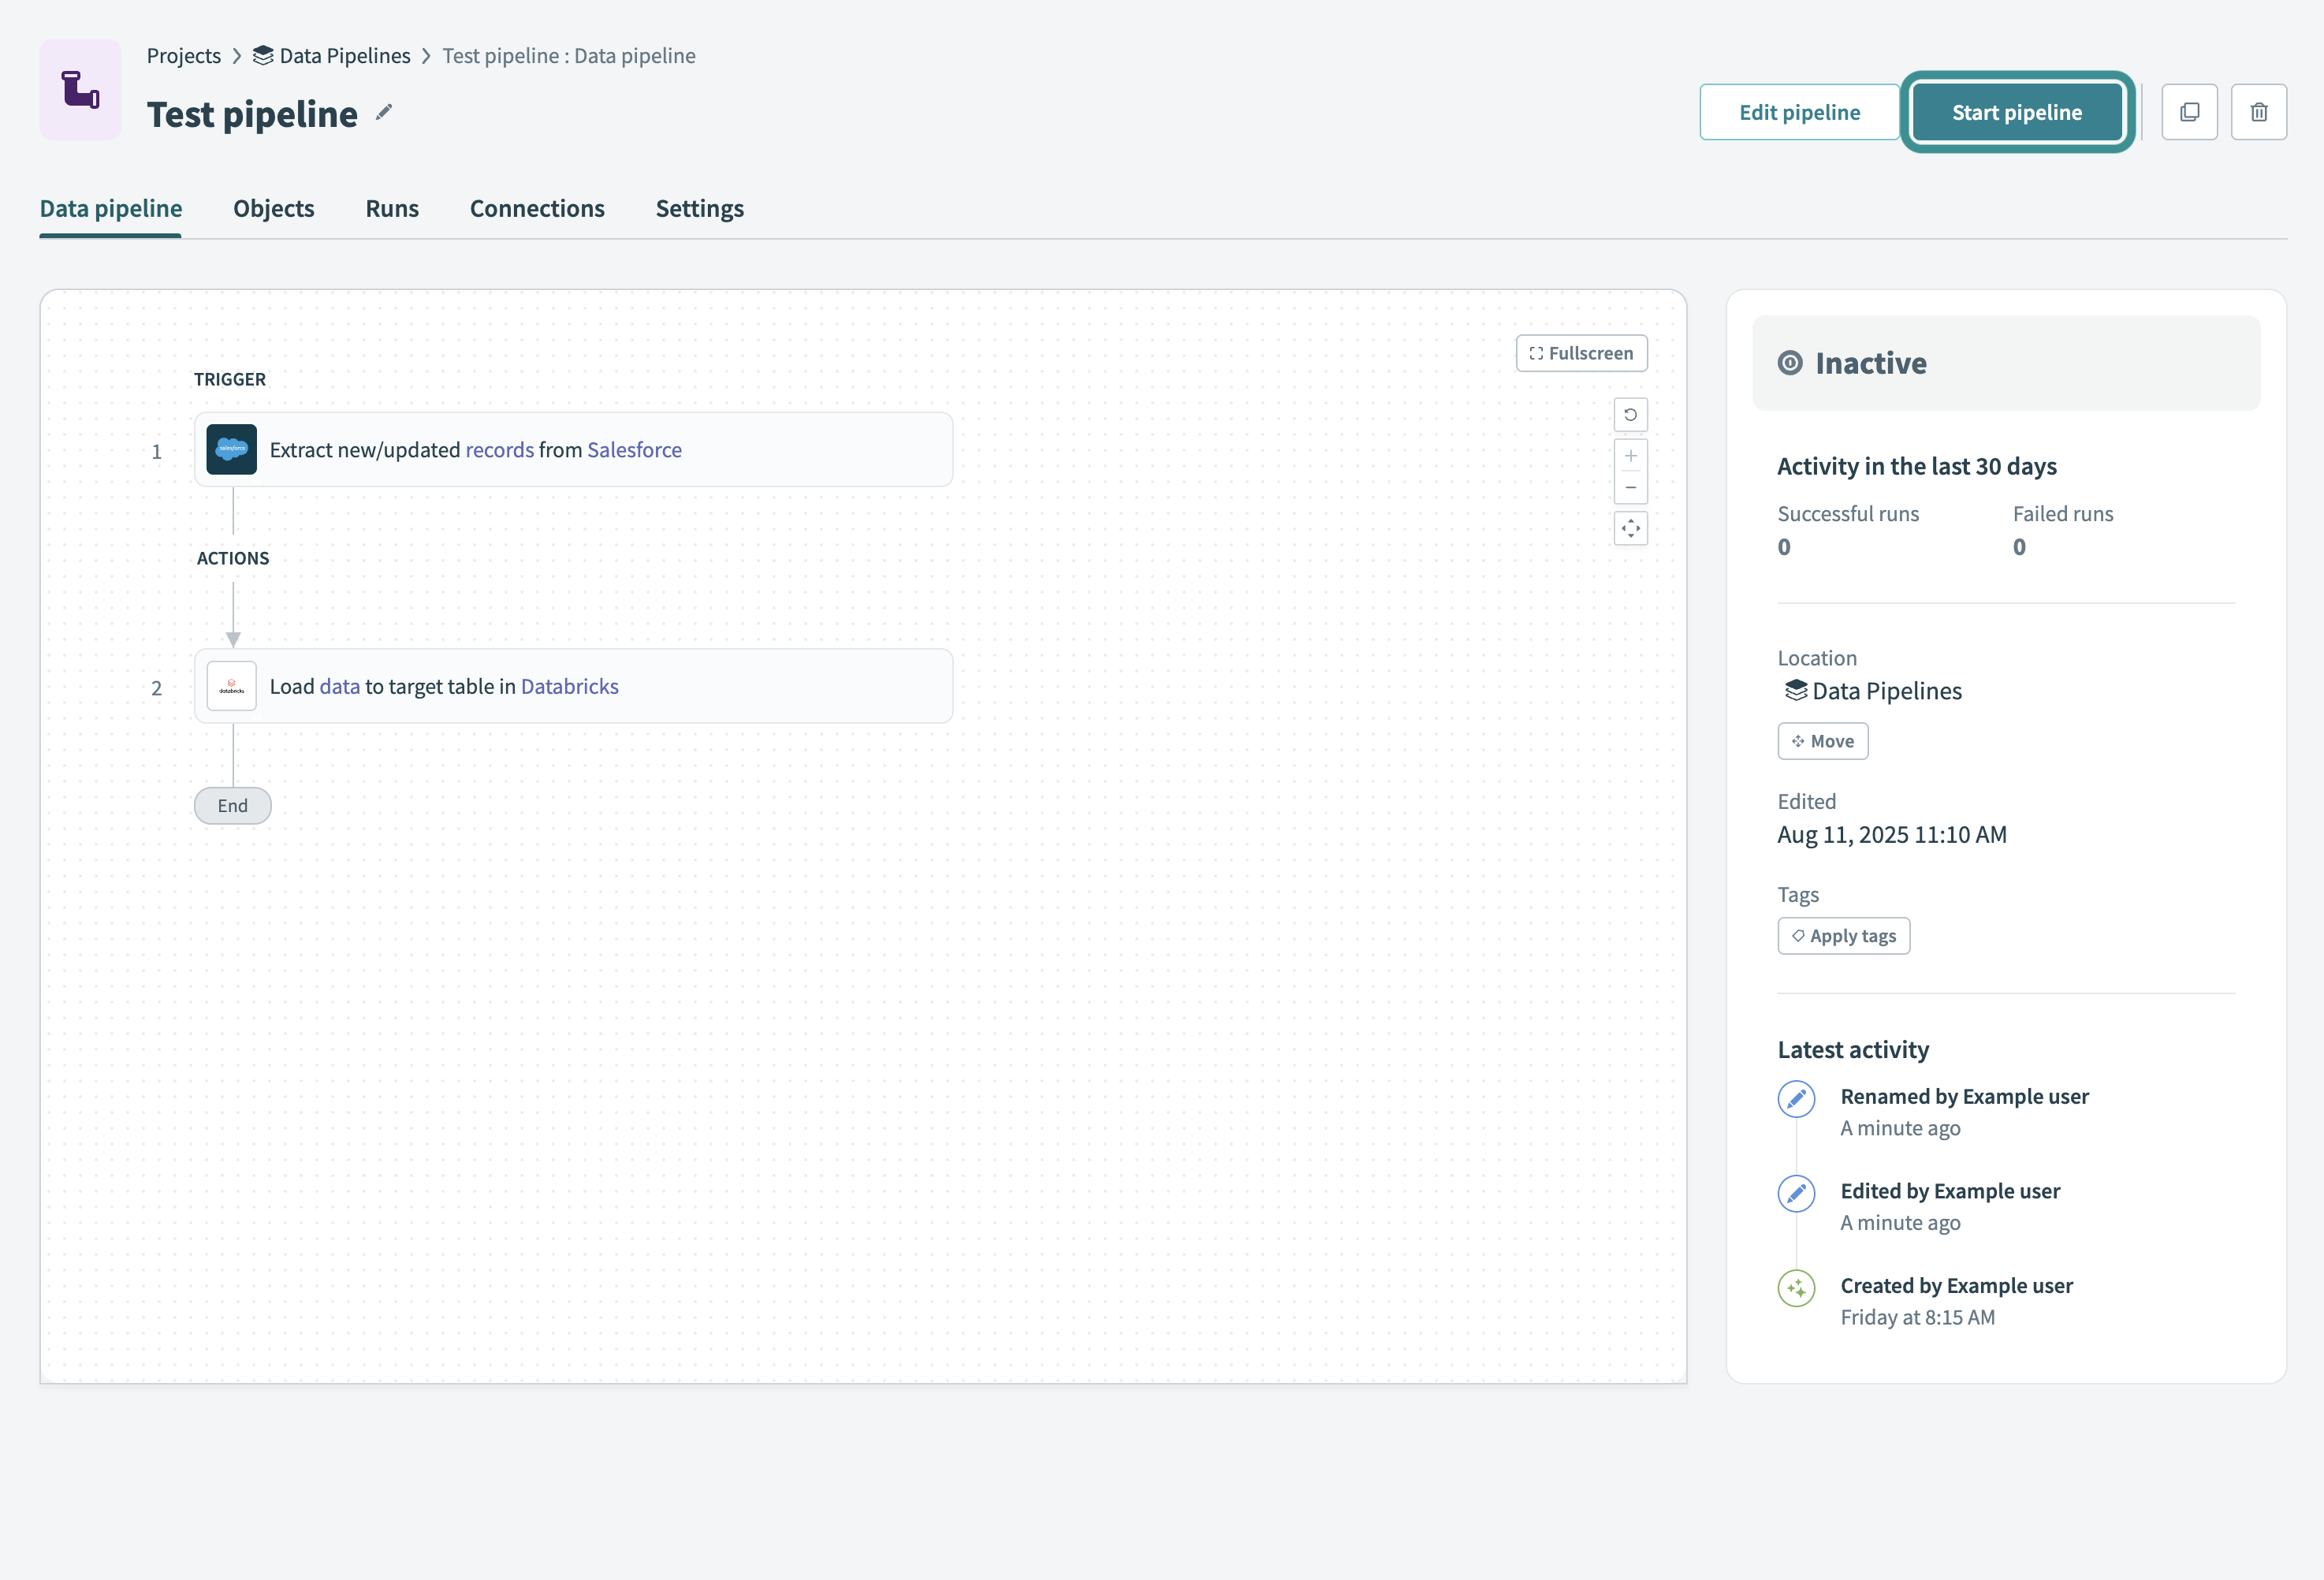 データパイプラインの開始
パイプラインに対して移動、編集、またはタグを適用を選択することもできます。
パイプラインアクティビティの監視方法と問題のトラブルシューティング方法については、データパイプラインレシピの監視ガイドを参照してください。
最終更新日: