Amazon S3をデータパイプラインソースとして設定する
Amazon S3をデータパイプラインソースとして設定し、レコードを抽出して同期先に同期します。このガイドでは、S3バケット内の.csvファイルと.parquetファイルを操作するためのコネクション設定、パイプライン設定、および主な動作について説明します。
サポートされている機能
Amazon S3をデータパイプラインソースとして使用する場合、次の機能がサポートされています。
- S3に保存されている
.csvファイルと.parquetファイルからデータを抽出して同期 - ファイル検出による完全同期および増分同期のサポート
- オブジェクト抽出のためのフィールドレベルの選択
- フィールドレベルのデータマスキング
前提条件
次の設定とアクセス権が必要です:
.csvファイルまたは.parquetファイルを保存するS3バケットを持つAWSアカウント- Workato用に設定されたIAMロール認証
- パイプラインがファイルを一覧表示して読み取るために必要なS3権限
- 同期するファイルのフォルダパスとファイルパターン
接続方法
データパイプラインソースとしてAmazon S3に接続するには、次の手順を完了します。このコネクションにより、パイプラインはS3から.csvファイルと.parquetファイルを読み取り、抽出できます。
アクセスキー認証は非推奨
WorkatoではIAMロール認証の使用を推奨しています。既存のコネクションではアクセスキー認証を引き続き使用できますが、Workatoでは新しいEnvironmentには推奨していません。
Amazon S3に接続
作成 > コネクションを選択するか、Cを2回押します。
Amazon S3を検索し、アプリとして選択します。
コネクション名フィールドに名前を入力します。
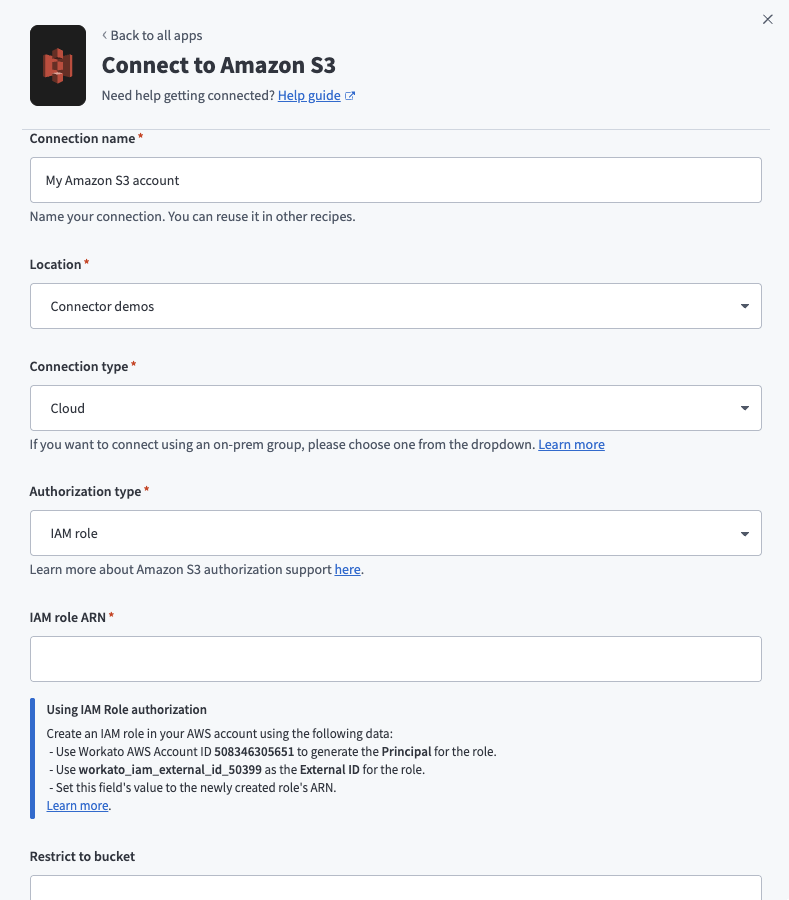 Amazon S3コネクション設定
ロケーションドロップダウンを使用して、コネクションを保存するプロジェクトを選択します。
オンプレミスグループ経由で接続する必要がない限り、コネクションタイプフィールドでCloudを選択します。
認可タイプとしてIAMロールを選択します。
AWSアカウントで設定されたロールのARNをIAMロールARNフィールドに入力します。 IAMロールには、パイプライン抽出に必要なバケットとフォルダへのアクセスをWorkatoに許可する権限が含まれている必要があります。
任意。コネクションを特定のバケットに制限するには、バケットに制限フィールドに値を入力します。 IAMロールの一覧表示権限が制限されている場合は、この設定を使用します。
S3バケットのリージョンを入力します。たとえば、S3コンソールのURLがhttps://us-west-1.console.aws.amazon.com/の場合は、us-west-1を入力します。
任意。ファイルダウンロードの同時実行数を増やすには、ダウンロードスレッドフィールドに値を入力します。デフォルト値は1で、最大値は20です。
接続を選択して、コネクションを確認および保存します。
パイプラインの設定
Amazon S3をデータパイプラインソースとして設定するには、次の手順を完了します。
作成 > データパイプラインを選択するか、C+Iを押します。
データパイプライン名フィールドにデータパイプラインの名前を入力します。
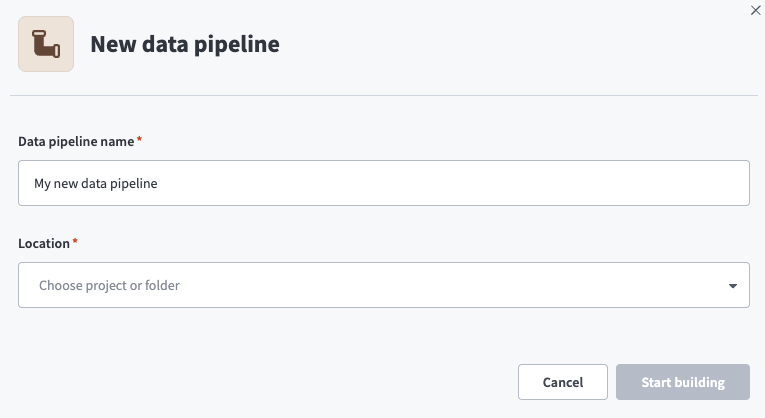 データパイプライン設定
ロケーションドロップダウンメニューを使用して、データパイプラインを保存するプロジェクトを選択します。
ビルドを開始をクリックします。
Extract new/updated records from source app トリガーをクリックします。このトリガーは、パイプラインがソースアプリケーションからデータを取得する方法を定義します。
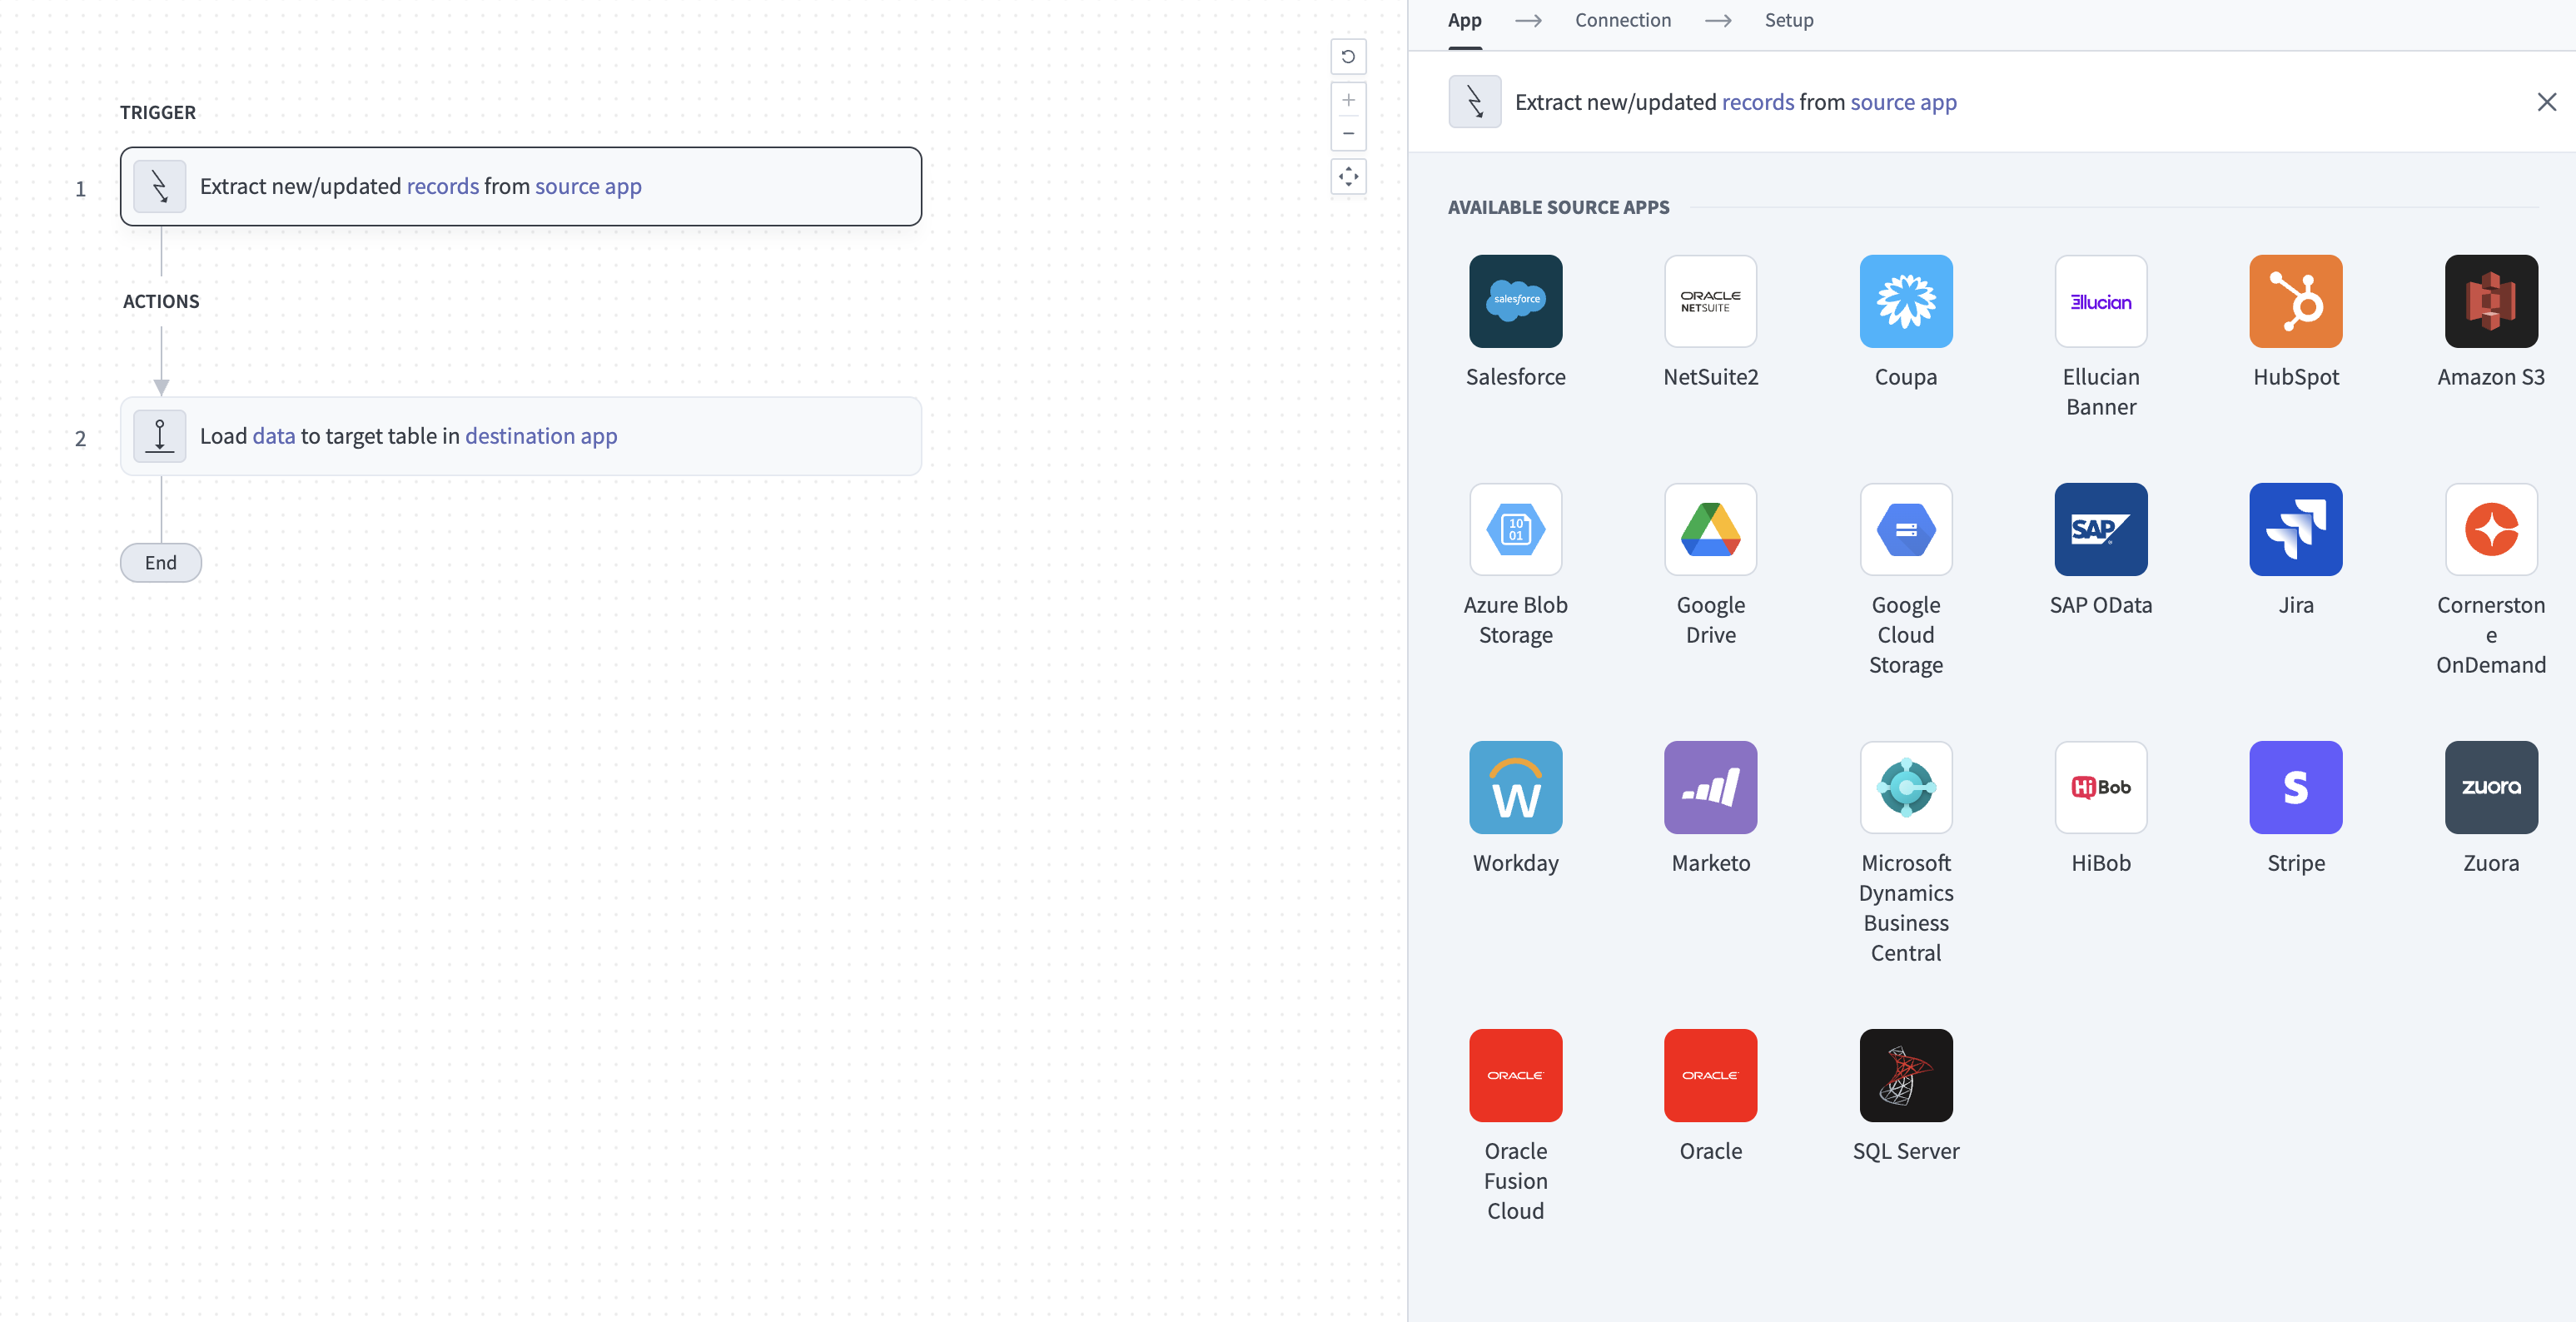 ソースアプリから新規/更新済みレコードを抽出トリガーを設定
Your Connected Source Apps ドロップダウンメニューを使用して、Amazon S3 を選択します。
このパイプラインで使用するAmazon S3コネクションを選択します。または、+ 新規コネクションをクリックして、新しいコネクションを作成します。
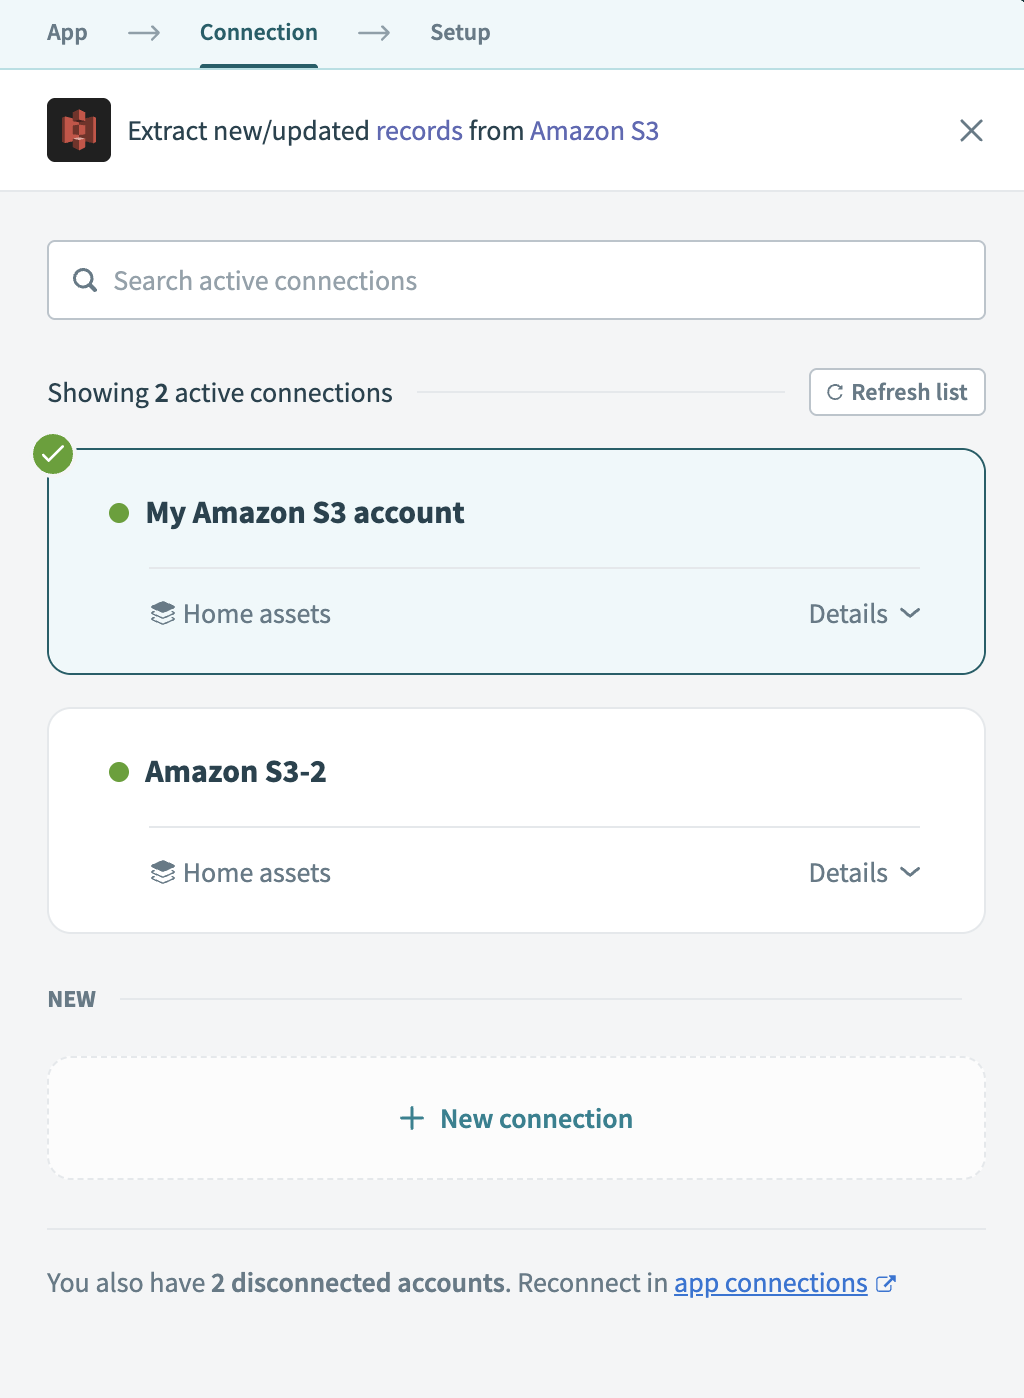 Amazon S3コネクションを選択
バケットフィールドで監視するS3バケットを選択します。
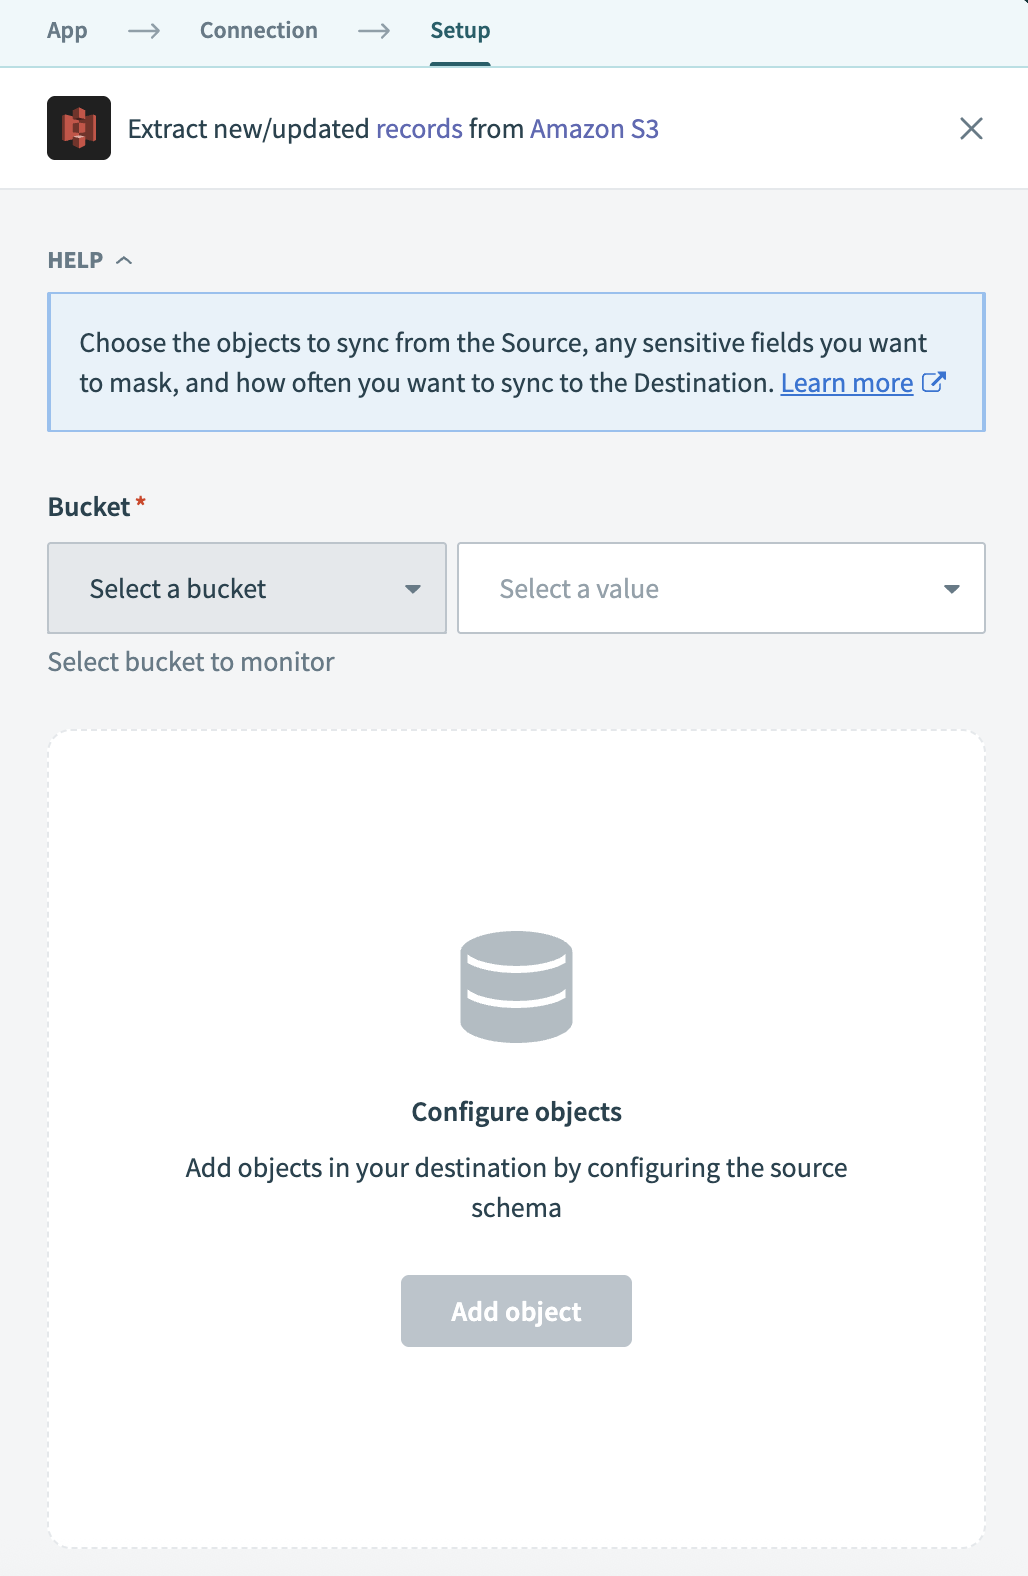 S3バケットを選択
オブジェクトを追加をクリックして、パイプラインで監視および同期するファイルを設定します。
WorkatoはS3バケットを自動的に参照しません。フォルダパスとファイルパターンを手動で入力する必要があります。パスとファイル名がS3の構造と一致していることを確認します。
ソースフォルダパスフィールドに、監視するバケット内のフォルダを入力します。パイプラインはこのフォルダを監視し、ファイル名パターンに一致するファイルを取得します。
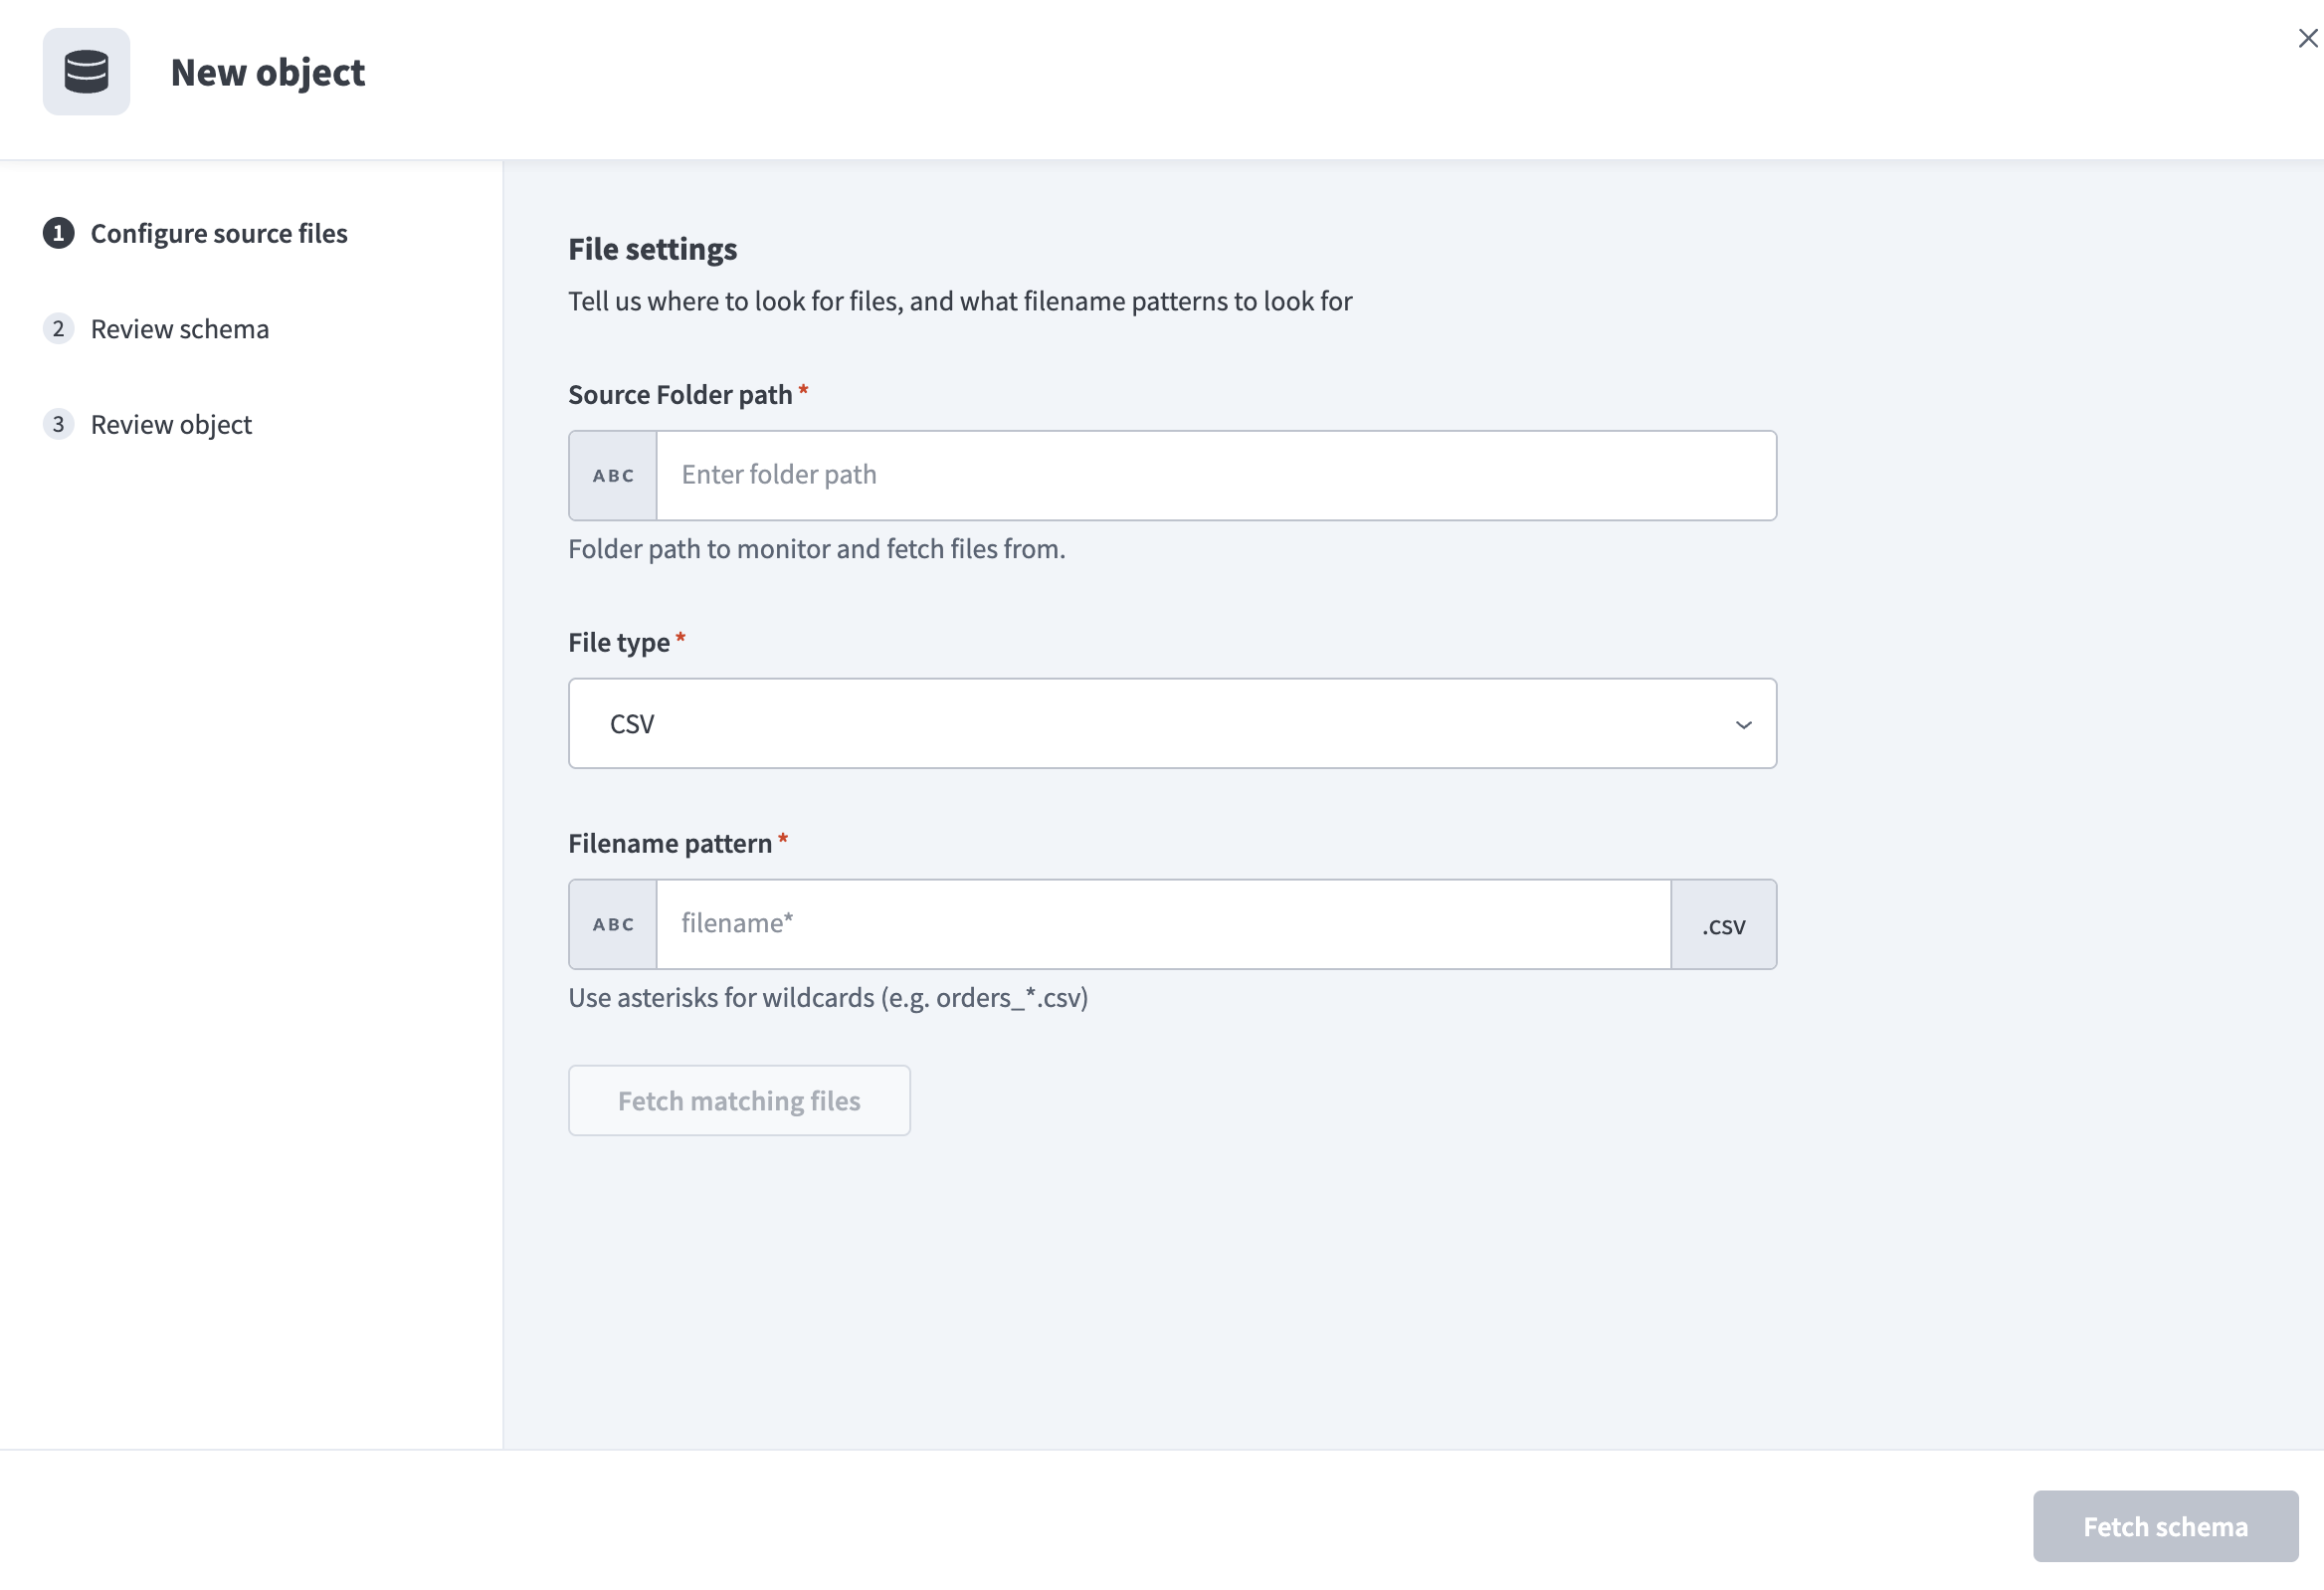 ファイル設定を構成
ファイルタイプドロップダウンメニューを使用して、抽出するファイル形式を選択します。 Workatoは次のファイルタイプをサポートしています。
- CSV:
.csvファイルからデータを抽出します。追加のファイルタイプ設定の構成が必要です。 - Parquet:
.parquetファイルからデータを抽出します。スキーマとデータ型はファイルから直接推測されます。
ファイル名パターンフィールドでパターンを使用して、取得するファイルを定義します。複数のファイルを含めるには、orders_* のようなワイルドカードを使用します。ファイル拡張子は、選択した File type に基づいて自動的に付加されます。
一致するファイルを取得をクリックして、定義したパターンに一致するファイルをプレビューします。
同期先テーブルのスキーマを定義する参照ファイルを選択します。
ファイルタイプ固有の設定を構成します:
参照ファイルからカラムを読み込んでプレビューするには、スキーマを取得をクリックします。
スキーマを確認し、想定されるテーブル構造と一致していることを確認します。スキーマプレビューには、ソースファイルの列と、次のシステム生成列が含まれます。
_file: 各行の元になったソースファイルの名前。_line: ソースファイル内の各レコードの行番号またはロー番号。
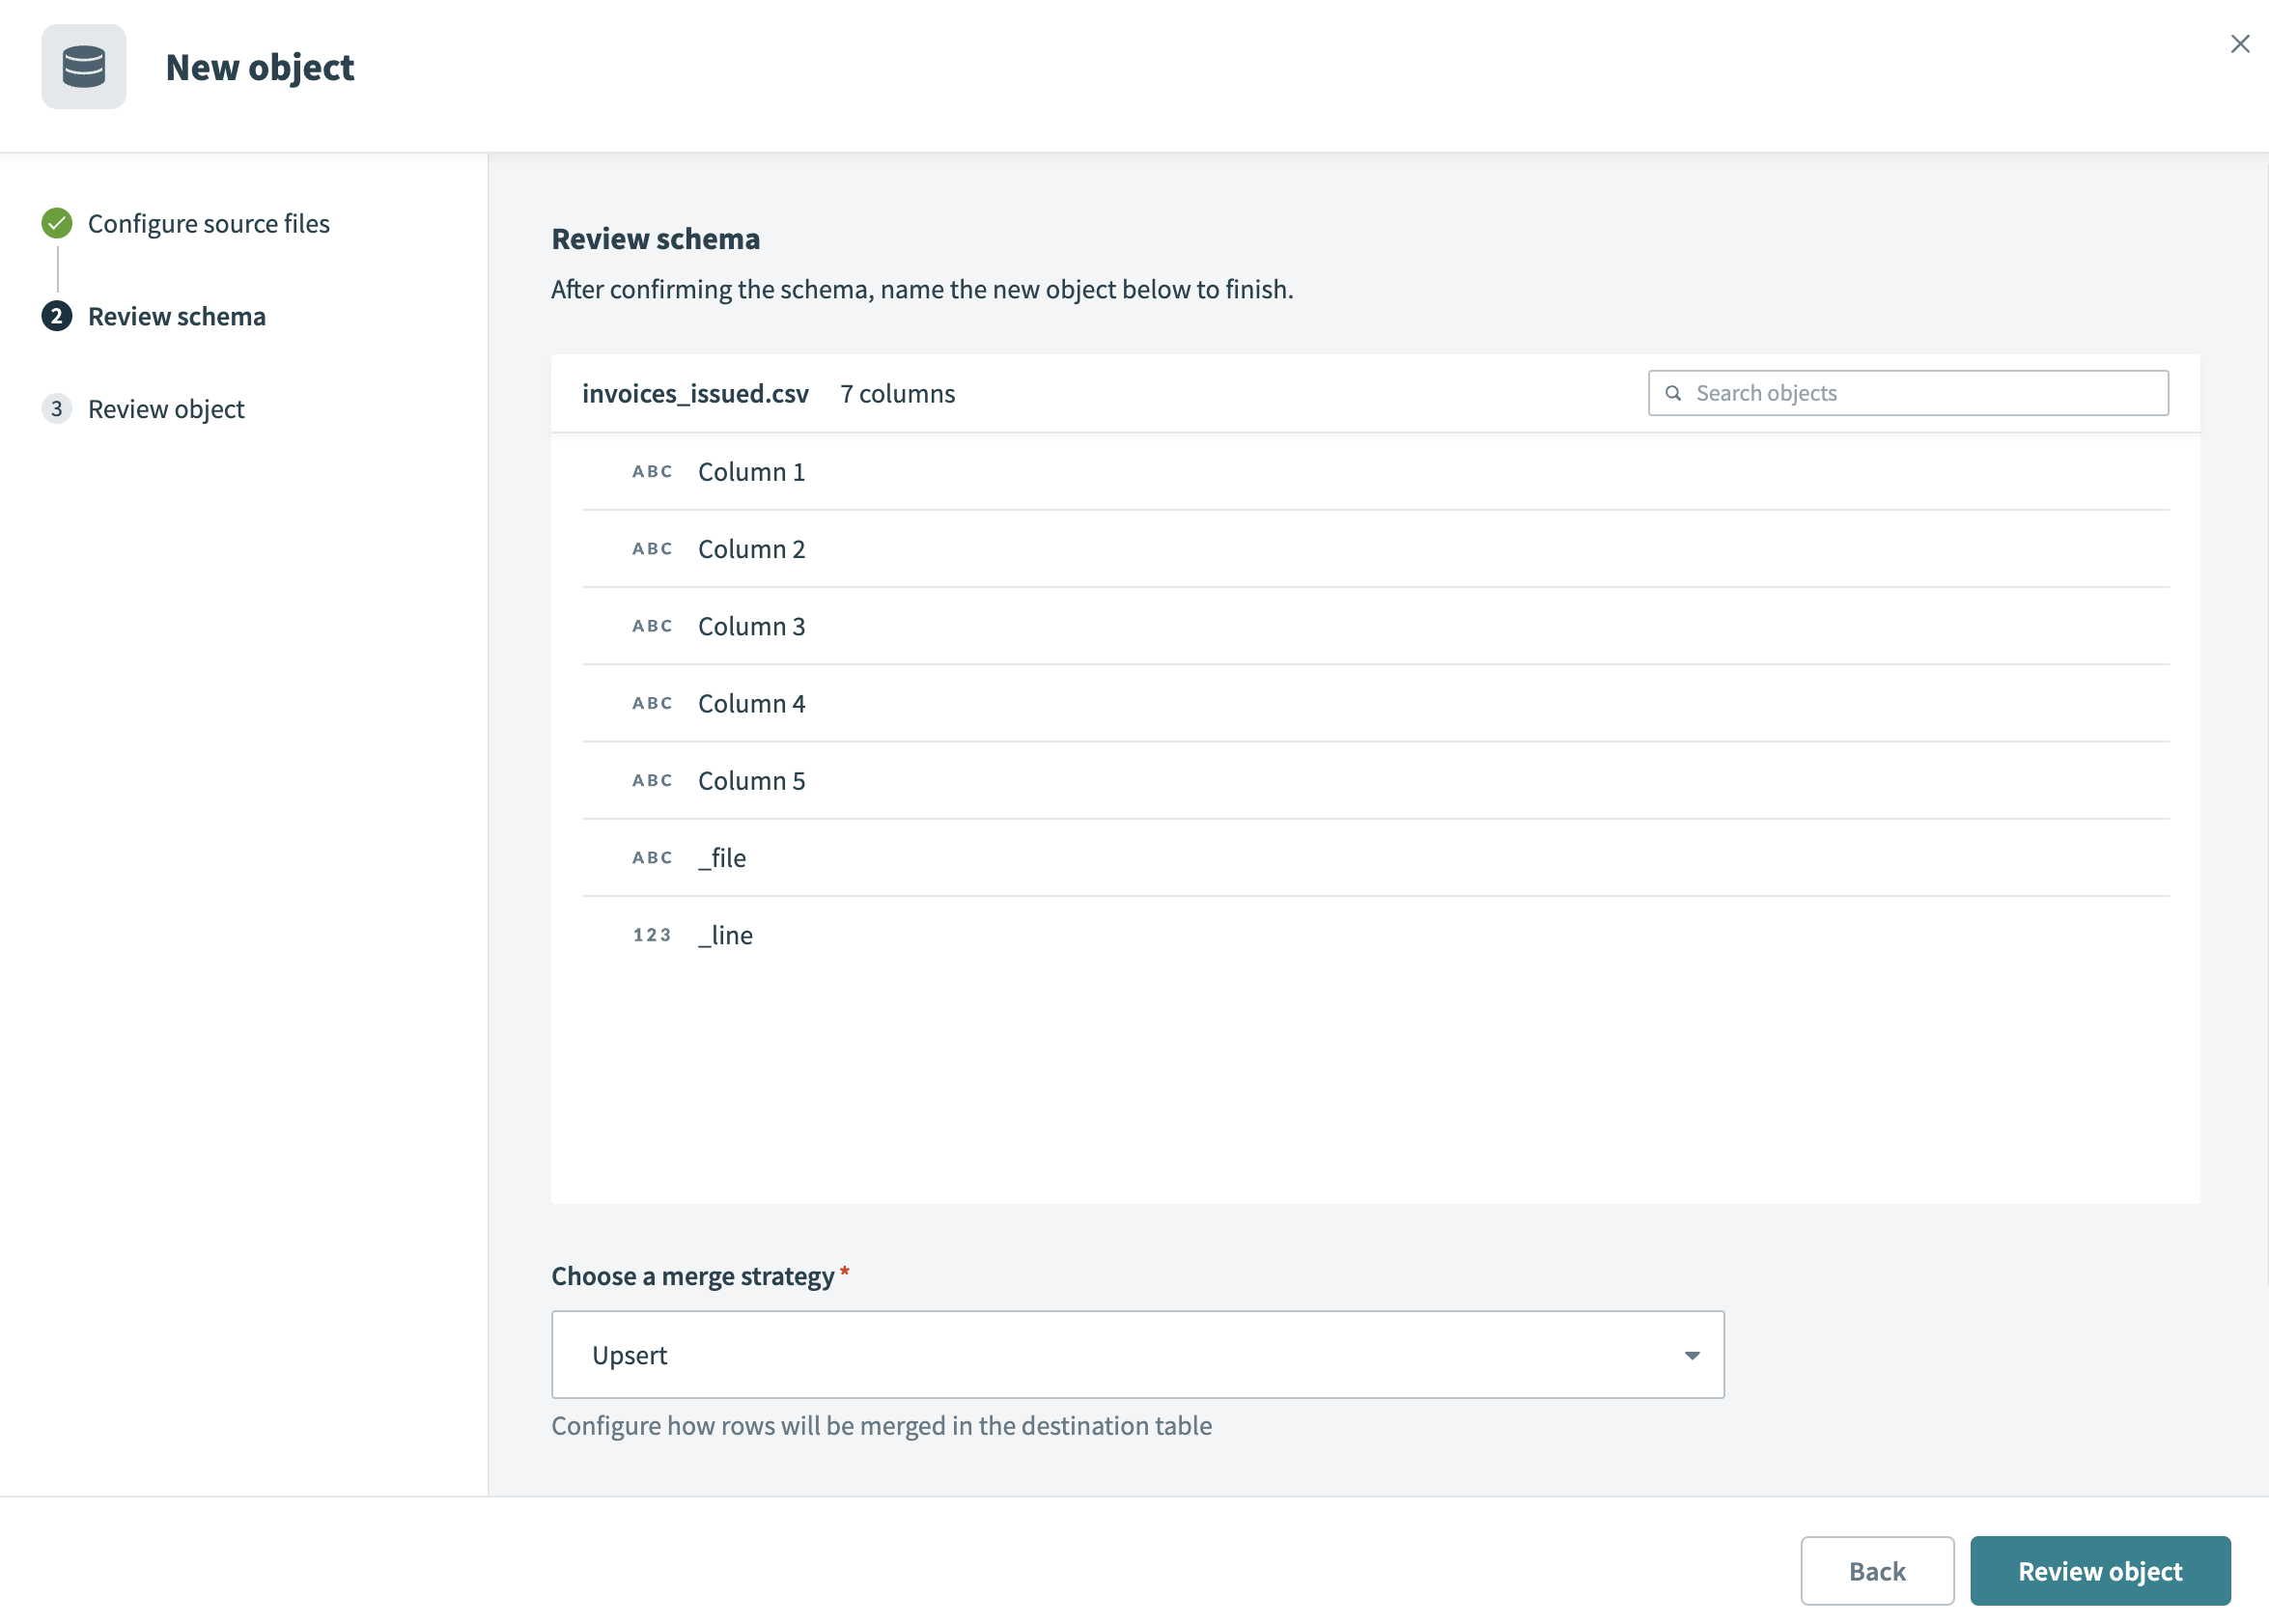 スキーマを確認
マージ戦略を選択フィールドで、宛先テーブル内の行をマージする方法を設定します。 Workatoは次のマージ戦略をサポートしています:
- アップサート: 新しい行を挿入し、既存の行を更新します。 Upsertを選択すると、Merge methodフィールドが表示されます。宛先テーブルのプライマリキーとして使用する列を1つ以上選択できます。 Merge methodを空白のままにすると、パイプラインはシステム生成の
_file列と_line列を複合主キーとして使用します。 - 追加のみ: 既存のレコードとの照合や更新を試みずに、すべての行を挿入します。パイプラインはキーで照合を行わず、Append only を選択した場合は既存の行を更新しません。
オブジェクトを確認をクリックして、設定を確認します。この画面には、ファイル設定、ファイルタイプ固有のオプション、マージの詳細が表示されます。
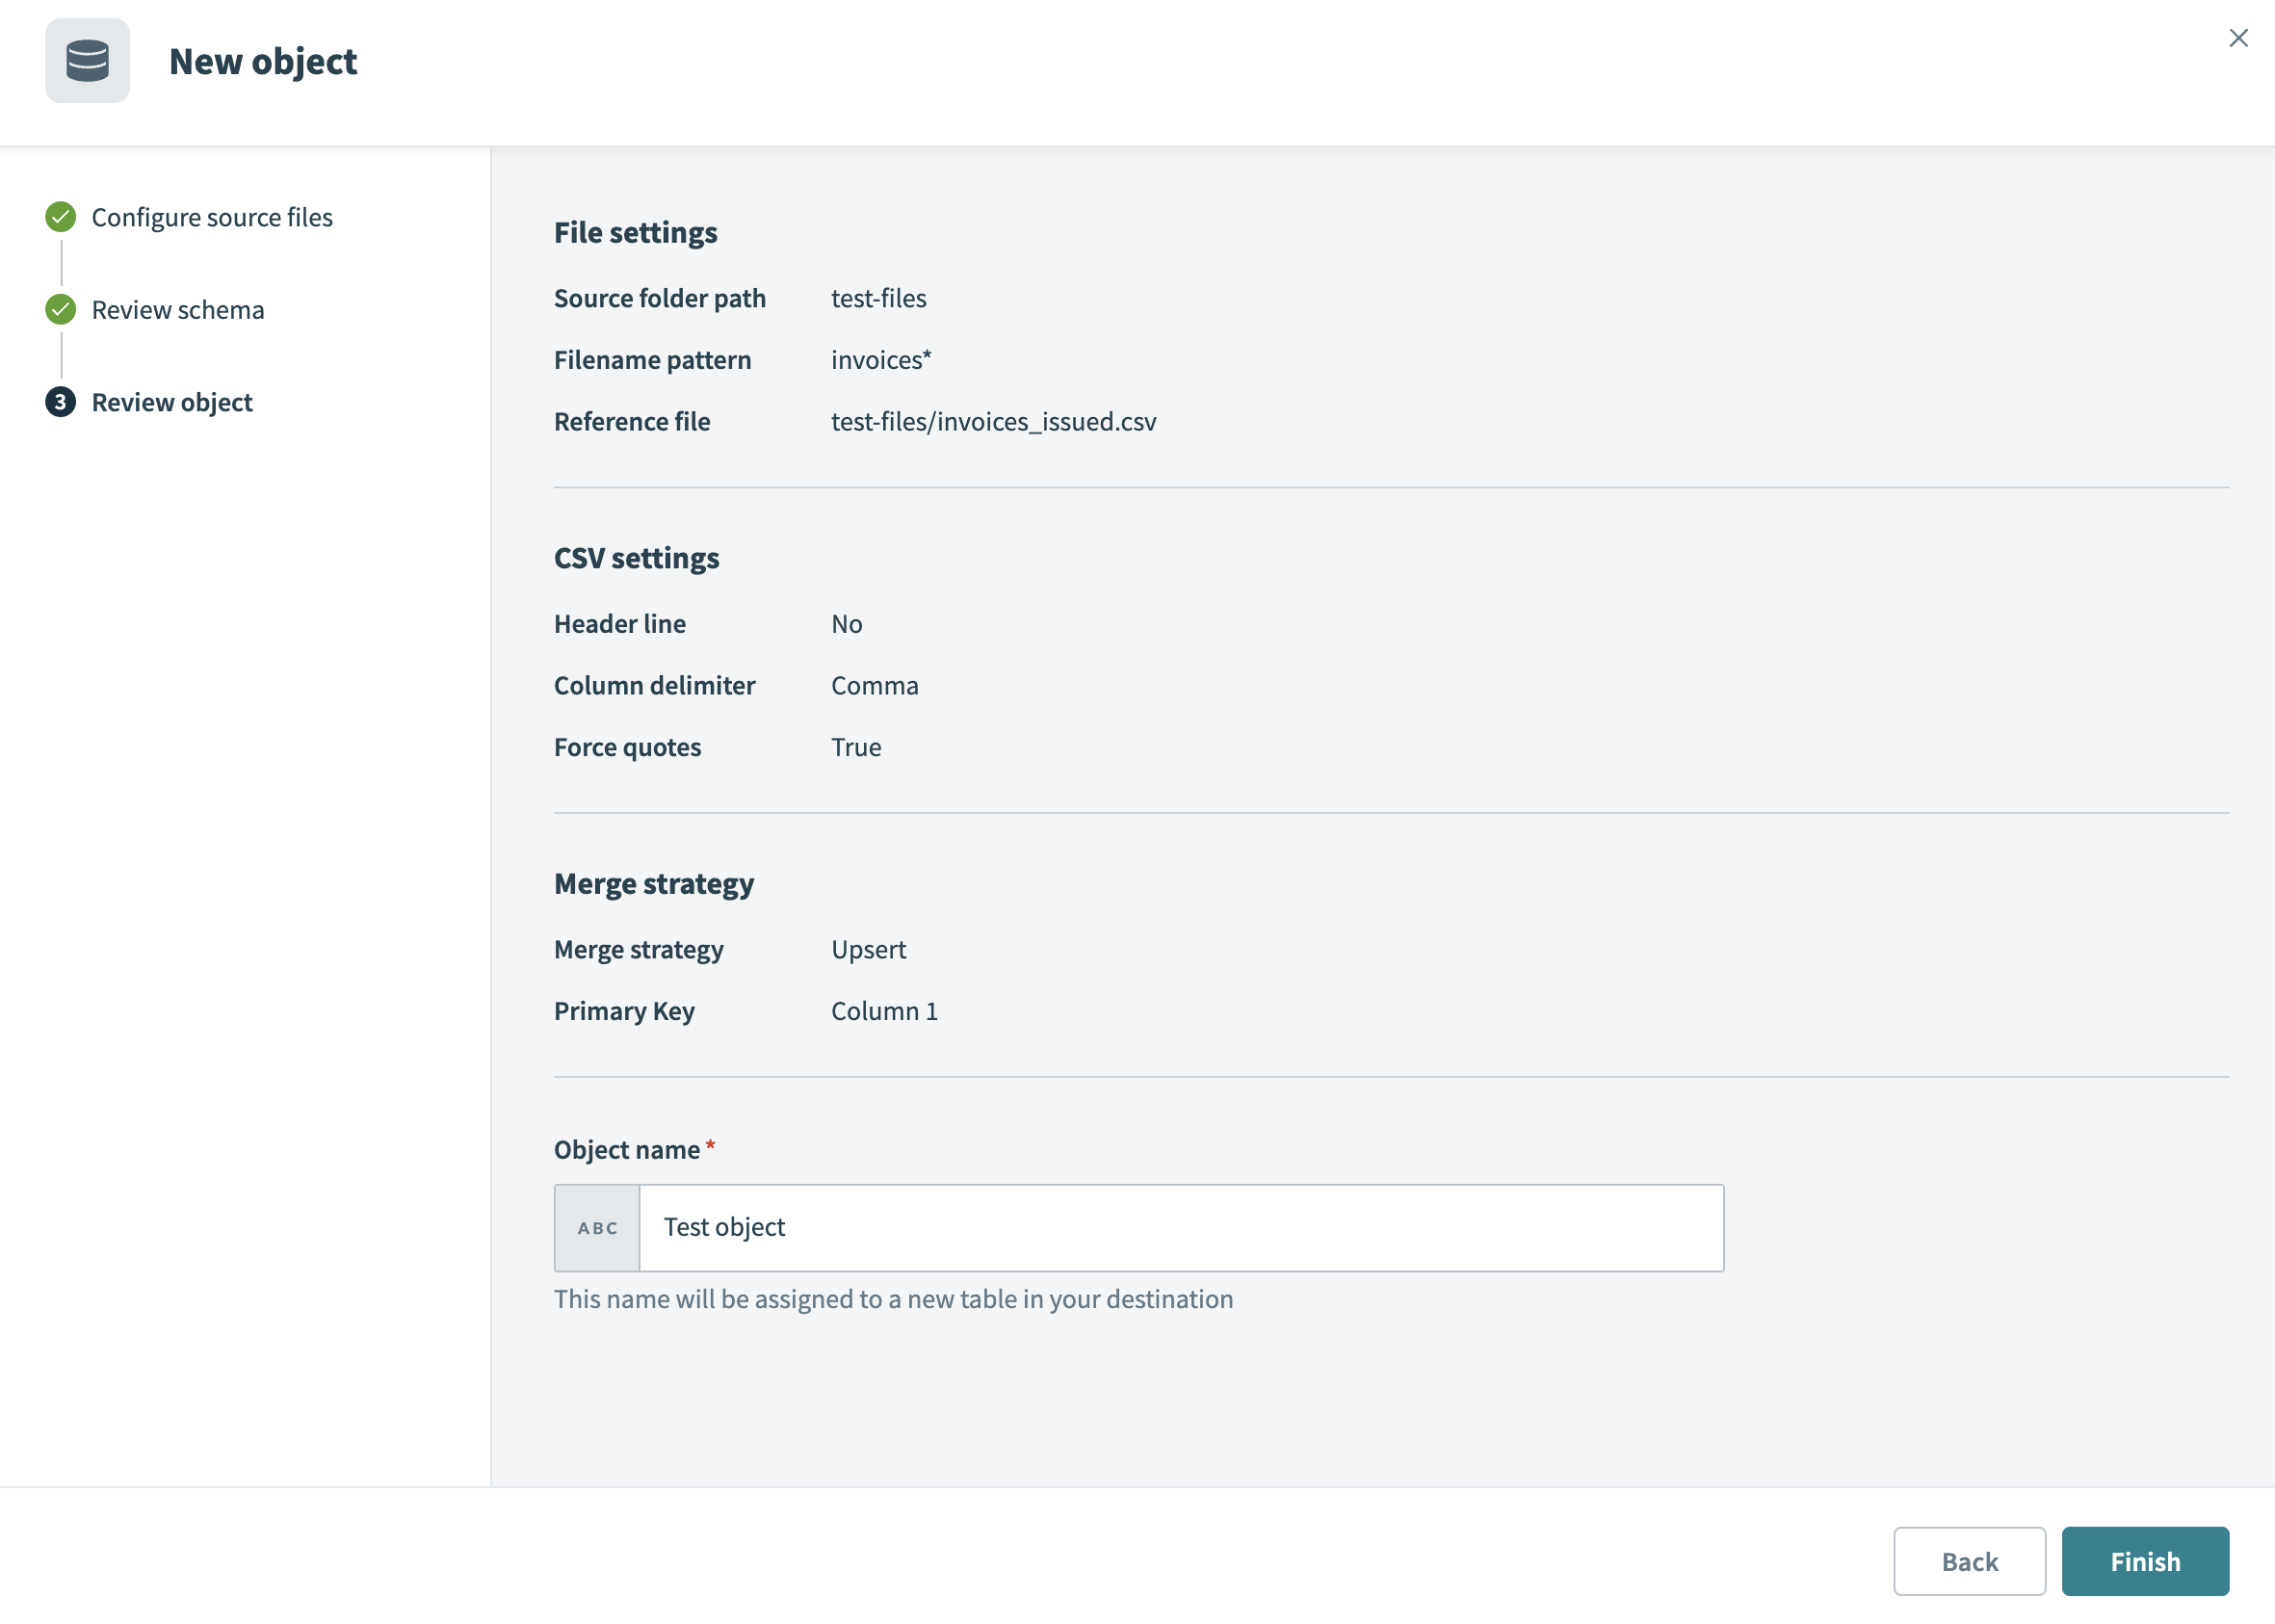 オブジェクトを確認
オブジェクト名を入力します。この名前は宛先テーブル名を定義します。
完了をクリックして、オブジェクト設定を保存します。
選択した各オブジェクトのスキーマを確認してカスタマイズします。オブジェクトを選択すると、パイプラインはそのスキーマを自動的に取得し、宛先がソースと一致するようにします。
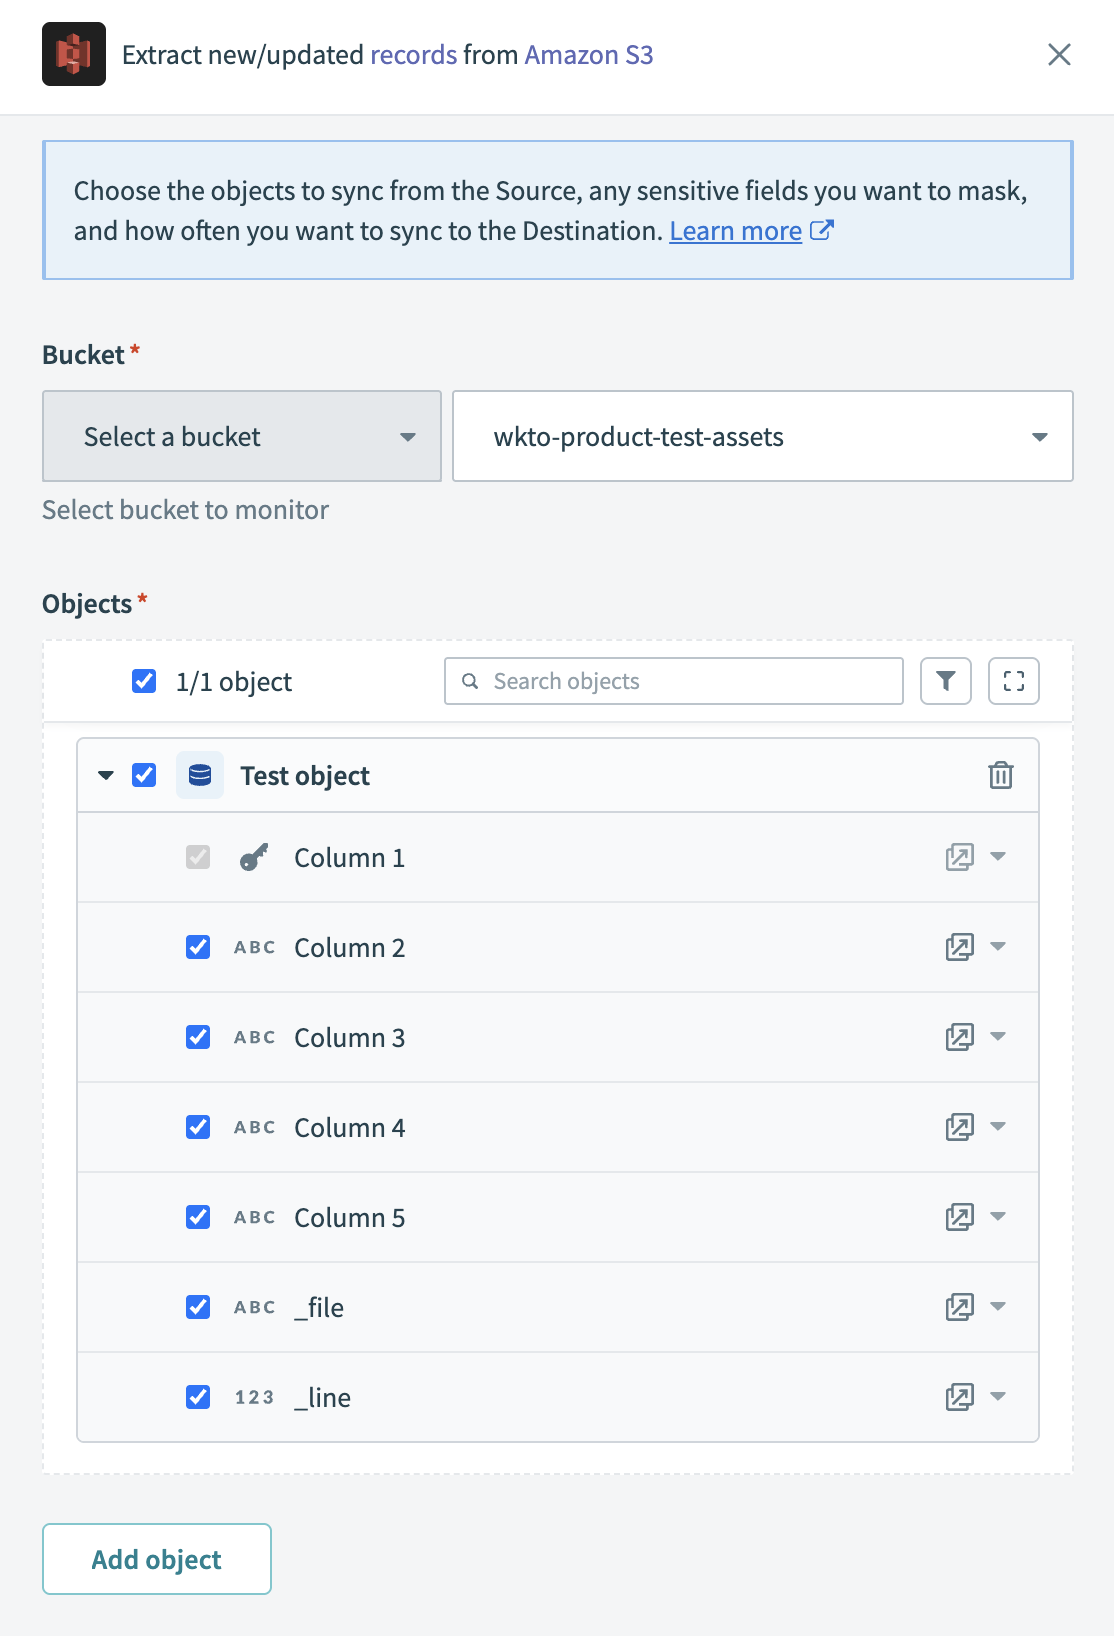 オブジェクトを展開
任意のオブジェクトを展開して、そのフィールドを表示します。使用可能なすべてのデータを抽出するにはすべてのフィールドを選択したままにし、データ抽出とスキーマレプリケーションから除外するには特定のフィールドの選択を解除します。
任意。フィールドレベルのデータ保護を設定します。オブジェクトを展開した後、各フィールドの処理方法を選択します:
- そのままレプリケート(デフォルト): ソースのデータ値が宛先に同一にレプリケートされます。
- ハッシュ: 宛先に同期する前に、列内の機密データ値をハッシュ化します。
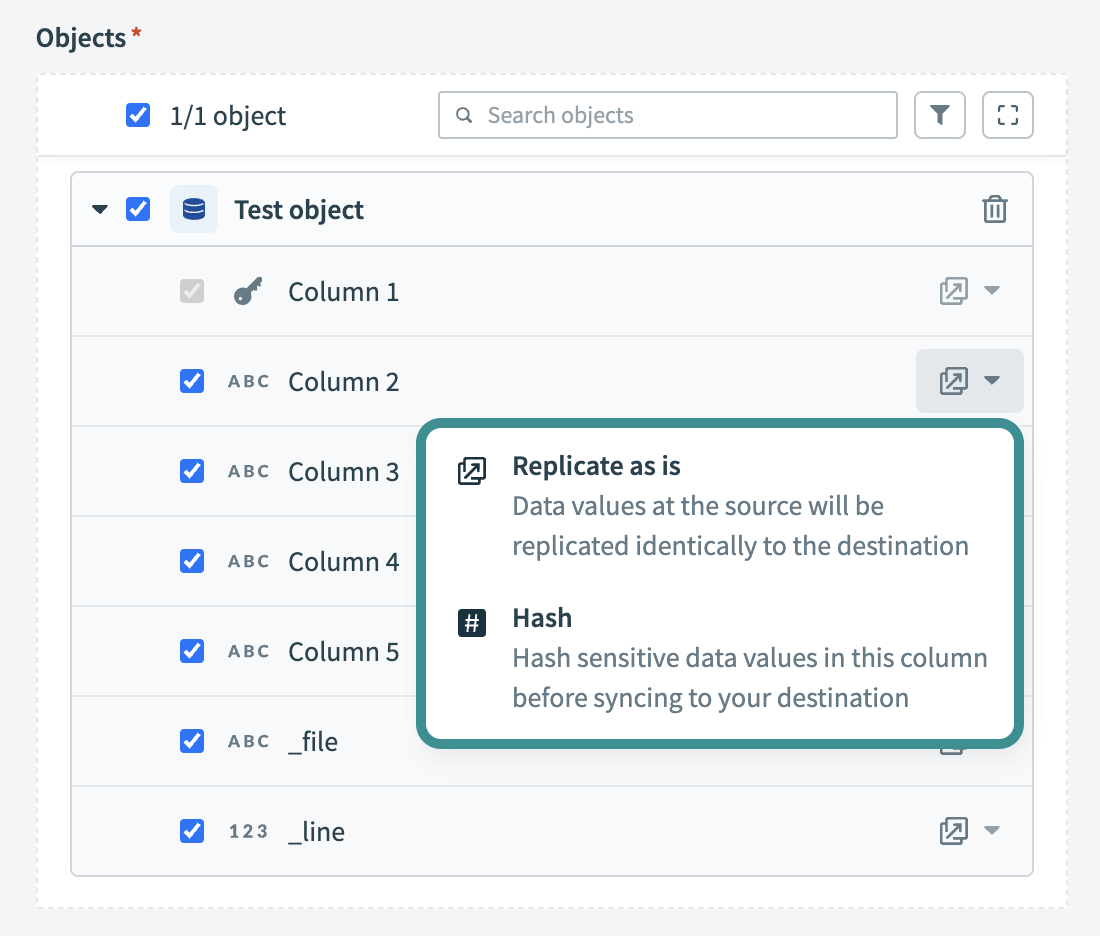 フィールドレベルのデータ保護を設定
同じフローを使用してさらにオブジェクトを追加するには、もう一度オブジェクトを追加をクリックします。この手順を繰り返して、パイプラインに複数のAmazon S3オブジェクトを含めることができます。
スキーマ変更の処理方法を選択ドロップダウンメニューを使用して、スキーマドリフトの処理オプションを選択します。
- 新しいフィールドを自動同期: ソースに追加された新しいフィールドを自動的に検出して同期します。
- 新しいフィールドをブロック: パイプラインの開始後、スキーマを固定します。新しいフィールドは手動で追加する必要があります。このオプションを使用すると、ソーススキーマが更新された場合に宛先が同期されなくなる可能性があります。
詳細については、スキーマのレプリケーションとスキーマドリフトの管理を参照してください。
Frequency(頻度)フィールドで、標準の時間ベースのスケジュールを選択するか、カスタムcron式を定義します。これにより、パイプラインがAmazon S3から送信先にデータを同期する頻度が決まります。
最終更新日: